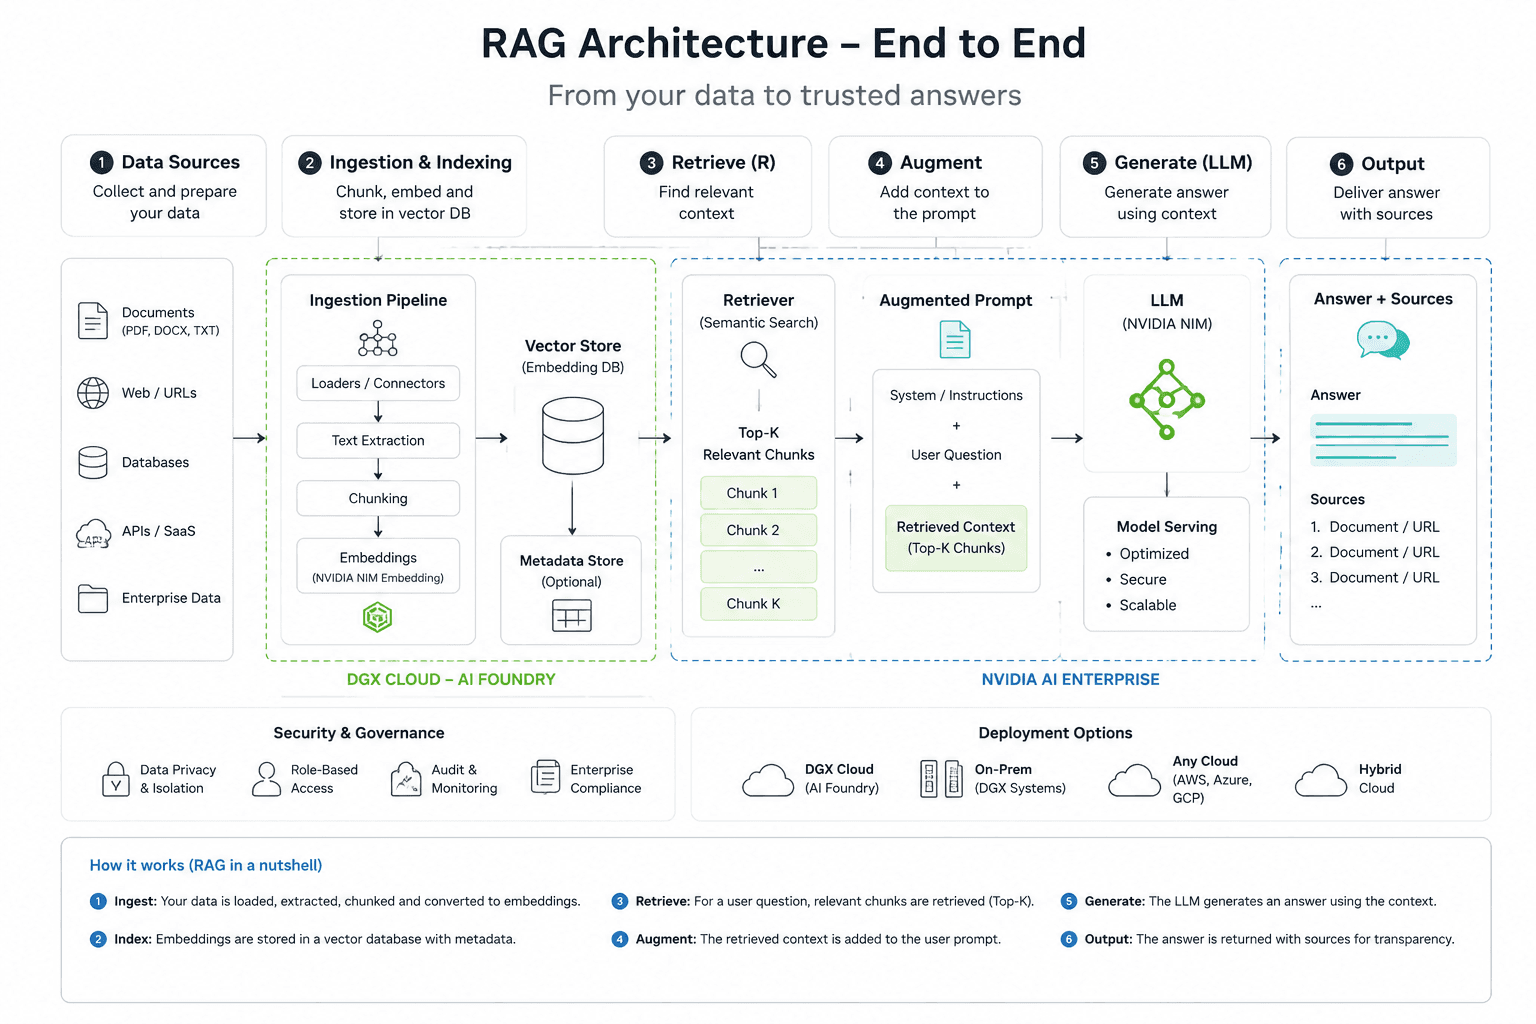
LLM, embedding, moteur d'inférence, base vectorielle, cloud GPU, plateforme GenAI — chaque brique a un rôle distinct. Ce guide clarifie qui fait quoi dans un pipeline RAG réel.
Pourquoi lire une architecture par couches
La confusion dans les projets GenAI vient rarement d'un manque de technologie. Elle vient d'une mauvaise lecture des responsabilités. Deux erreurs reviennent en boucle : croire qu'une API LLM suffit à tout résoudre, ou à l'inverse assembler une stack complexe avant d'avoir validé le moindre cas d'usage.
Une architecture RAG robuste ressemble à une chaîne de responsabilités. Chaque maillon a un rôle précis, des fournisseurs différents, et des compromis qui lui sont propres. Les confondre, c'est prendre de mauvaises décisions d'achat, de déploiement et de gouvernance.
Sources métier → ingestion → chunking → embeddings → vector DB
              → retrieval → prompt augmenté → LLM → réponse sourcée
Les six couches d'un pipeline RAG
Chaque couche répond à une question précise. Les confondre, c'est par exemple choisir un cloud parce qu'il propose un LLM pratique, en oubliant de réfléchir à la base vectorielle, au moteur d'inférence ou à la stratégie de chunking.
| Couche | Rôle | Exemples représentatifs |
|---|---|---|
| Modèle LLM | Génère du texte, raisonne, synthétise. C'est le cerveau du système. | GPT-4o, Claude 3.5 Sonnet, Llama 3.1, Mistral Large, Gemini 1.5 Pro, Nemotron |
| Modèle d'embedding | Transforme les textes en vecteurs numériques comparables. Essentiel pour la recherche sémantique. | OpenAI text-embedding-3, Cohere Embed v3, Mistral Embed, NVIDIA NV-Embed, BGE |
| Moteur d'inférence | Expose le modèle via une API, optimise le débit et la latence en production. | NVIDIA NIM, vLLM, Hugging Face TGI, Ollama (local), llama.cpp (edge) |
| Base vectorielle | Stocke les embeddings et répond aux requêtes de recherche sémantique à grande échelle. | Pinecone, Milvus, Weaviate, pgvector, OpenSearch, Qdrant |
| Infrastructure GPU | Fournit la capacité de calcul pour l'inférence et l'entraînement. | AWS EC2 (A100/H100), Azure GPU VMs, GCP Vertex AI, OCI, DGX Cloud |
| Plateforme GenAI | Orchestre les couches : gestion des modèles, évaluation, guardrails, agents, RAG managé. | Amazon Bedrock, Azure AI Foundry, Vertex AI, Databricks Mosaic AI |
La ligne de partage la plus importante : le modèle LLM n'est pas la plateforme. La base vectorielle n'est pas le moteur d'inférence. Le cloud GPU n'est pas une stratégie RAG. Chaque couche se choisit, se déploie et s'exploite indépendamment des autres.
Le pipeline RAG en détail
Le RAG — Retrieval-Augmented Generation — connecte un LLM à des données externes au moment de la question. L'intérêt : répondre à partir de documents internes, de tickets récents, de bases métier ou de tout contenu qui n'existait pas au moment de l'entraînement du modèle.
Phase d'ingestion (batch ou background)
Les sources brutes — PDF, bases SQL, APIs, SaaS, sites web — sont extraites, découpées en chunks, transformées en vecteurs par un modèle d'embedding, puis stockées dans la base vectorielle. Ce coût est payé une fois, pas à chaque question.
Phase runtime (à chaque question)
La question de l'utilisateur est elle aussi vectorisée. La base vectorielle retourne les passages les plus proches sémantiquement. Ces passages enrichissent le prompt envoyé au LLM, qui produit une réponse sourcée et vérifiable.
# Ingestion (one-time ou incrémental)
document → chunks → embed(chunk) → vector_db.upsert()

# Runtime — RAG naïf
query → embed(query) → vector_db.search(k=20) → top-k chunks → LLM → réponse

# Runtime — RAG avancé
query → rewrite(query) → hybrid_search(vector + BM25) → rerank(top-k) → LLM → réponse
Du RAG naïf au RAG avancé
Le pipeline linéaire est un point de départ, pas une cible. En production, trois techniques améliorent sensiblement la qualité du retrieval sans toucher au reste de l'architecture.
Query rewriting. La requête brute est souvent un mauvais signal de recherche — trop courte, ambiguë, chargée de contexte conversationnel. Un LLM léger la reformule avant le retrieval pour améliorer le recall. Variante : HyDE (Hypothetical Document Embedding), qui génère un document fictif répondant à la question et l'utilise comme vecteur de recherche.
Hybrid search. La recherche vectorielle seule est forte sur la similarité sémantique mais faible sur les correspondances exactes (noms propres, identifiants, termes techniques). Combiner vectoriel et BM25 (recherche plein texte) via une fusion de scores — RRF ou pondération manuelle — améliore le recall sur les deux types de requêtes.
Re-ranking. La base vectorielle retourne k candidats classés par similarité cosinus. Un cross-encoder — modèle plus lent mais plus précis — les reclasse en tenant compte du contenu réel de la question et du passage. On ne garde alors que les 3 à 5 meilleurs pour le prompt final. Cohere Rerank, BGE Reranker et Jina Reranker sont les options les plus utilisées.
Synchronisation incrémentale
Pour les corpus qui évoluent, réindexer l'intégralité à chaque changement n'est pas viable. Les architectures sérieuses distinguent les documents nouveaux des documents modifiés via un champ updated_at, un webhook, un connecteur SaaS ou un pipeline CDC (Debezium, Kafka). Seul le delta est réindexé.
Moteurs d'inférence : qui fait quoi
Le moteur d'inférence est la couche qui expose le modèle LLM via une API et optimise son exécution. C'est lui qui gère le batching des requêtes, la quantification, la gestion mémoire GPU et la latence. Il est souvent invisible côté applicatif, mais déterminant côté performance et coût.
| Moteur | Contexte d'usage | Points forts | Limites |
|---|---|---|---|
| NVIDIA NIM | Production enterprise, stack NVIDIA | Containers TensorRT-LLM préconfigurés, optimisations GPU, support enterprise | Fortement lié à l'écosystème NVIDIA |
| vLLM | Production open source haute performance | PagedAttention pour le débit, très adopté, supporte la majorité des modèles ouverts | Support enterprise via intégrateurs |
| Hugging Face TGI | Production open source, fort alignement HF | Intégration native avec le Hub Hugging Face, Inference Endpoints | Moins clé en main qu'une solution enterprise |
| Ollama | Développement local et prototypage | Installation en une commande, idéal pour tester sans infrastructure | Non conçu pour le serving multi-utilisateurs |
| llama.cpp | Edge, appareils limités, modèles quantifiés | Inférence CPU efficace, supporte GGUF, très léger | Moins adapté au serving centralisé à grande échelle |
La règle de sélection est simple : Ollama pour développer localement, vLLM ou TGI pour la production open source, NIM si la stack est optimisée NVIDIA. Pour les API managées — OpenAI, Anthropic, Mistral, Cohere — le moteur d'inférence est géré par le fournisseur : la question ne se pose pas côté client.
L'écosystème NVIDIA dans un pipeline RAG
NVIDIA n'est pas qu'un fabricant de GPU. Son écosystème couvre plusieurs couches simultanément, ce qui génère souvent de la confusion. Le point clé : ces briques sont indépendantes et peuvent être utilisées séparément.
| Terme | Rôle dans un pipeline RAG |
|---|---|
| Nemotron | Famille de LLM NVIDIA, optimisés pour les workloads enterprise et la synthèse de données. Un choix de modèle parmi d'autres. |
| NIM | Microservices d'inférence containerisés. Packaging prêt à déployer autour de TensorRT-LLM, avec optimisations GPU, batching et monitoring. |
| NeMo | Framework pour le training, le fine-tuning et l'adaptation de modèles sur données métier. Pertinent si le projet implique un entraînement custom. |
| AI Enterprise | Suite logicielle enterprise : support, sécurité, intégrations certifiées, NIM + NeMo + Guardrails packagés pour la production. |
| DGX Cloud | Plateforme GPU managée pour les workloads IA intensifs. Disponible via AWS, Azure, GCP et OCI — ce n'est pas un cloud alternatif. |
| NGC | Registre et catalogue central : containers Docker, modèles pré-entraînés, SDK, Helm charts. Point de distribution pour NIM et AI Enterprise. |
Dans un pipeline RAG, NVIDIA intervient principalement sur deux couches : l'infrastructure GPU (DGX Cloud ou instances cloud partenaires) et le moteur d'inférence (NIM). NeMo est pertinent si le projet implique du fine-tuning. Nemotron est un choix de modèle — il n'impose pas le reste de la stack NVIDIA.
AWS, Azure, GCP : ce qu'on choisit vraiment
Les trois grands clouds proposent chacun une offre GenAI complète, mais avec des positionnements différents. La décision ne porte pas sur « qui a les meilleurs modèles » — tous proposent les mêmes via des partenariats — mais sur le niveau d'abstraction souhaité et la compatibilité avec l'infrastructure existante.
| Besoin | AWS | Azure | GCP |
|---|---|---|---|
| API modèles managée | Amazon Bedrock | Azure AI Foundry / Azure OpenAI | Vertex AI Model Garden |
| Plateforme ML | Amazon SageMaker | Azure Machine Learning | Vertex AI Pipelines |
| Louer des GPU | EC2 P4/P5 (A100/H100) | Azure ND A100 / H100 | GCP A3 (H100) / TPU v5 |
| Déployer un modèle open source | EC2 + vLLM/TGI | AKS + vLLM/TGI | GKE + vLLM/TGI |
| RAG managé | Bedrock Knowledge Bases | Azure AI Search + Foundry | Vertex AI Search |
API managée vs self-hosted : les plateformes managées réduisent la charge opérationnelle mais créent une dépendance au cloud. Le self-hosted donne plus de contrôle — sur le modèle, les coûts, la latence — mais exige une équipe capable de l'opérer. Le choix dépend du stade du projet, des contraintes de gouvernance et de la stratégie cloud.
Sur NVIDIA : DGX Cloud est une offre d'infrastructure GPU dédiée, disponible via les clouds partenaires. Ce n'est pas un cloud alternatif — c'est une couche infrastructure spécialisée qui s'y superpose.
Checklist avant de designer un RAG en production
- ✅ Identifier les sources de données, leur volume et leur fréquence de mise à jour.
- ✅ Définir la stratégie de chunking, le modèle d'embedding et la base vectorielle selon les contraintes de latence et de gouvernance.
- ✅ Choisir le niveau d'abstraction : API managée (Bedrock, Foundry, Vertex) ou self-hosted (vLLM, TGI, NIM).
- ✅ Séparer la phase d'indexation (batch) de la phase runtime et prévoir la synchronisation incrémentale.
- ✅ Prévoir l'évaluation dès le départ : pertinence du retrieval, taux d'hallucination, citations, latence P95.
- ✅ Traiter la sécurité comme une couche à part : droits d'accès aux documents, isolation des tenants, audit.
- ✅ Séparer prototype local, pilote métier et architecture cible en production.
Ce qu'il faut retenir
Un pipeline RAG n'est pas un chatbot avec une base vectorielle. C'est une architecture à six couches, chacune avec ses propres fournisseurs, ses propres compromis et ses propres critères d'exploitation. La vraie compétence consiste à lire ces couches séparément, puis à les assembler selon le besoin métier, le budget, les contraintes de gouvernance et le niveau de maturité de l'équipe.
Aucun fournisseur ne couvre toutes les couches de façon optimale. Les API managées simplifient le démarrage, le self-hosted donne le contrôle. L'écosystème NVIDIA est pertinent sur l'infrastructure et le serving, pas sur tout le pipeline. Le choix de cloud dépend avant tout de l'infrastructure existante et des contraintes de souveraineté — pas des modèles disponibles, ils sont partout.